PDFファイル登録の仕組み
文書DB画面で、画面にファイルをドラッグアンドドロップすると、文書登録ができます。
弁護革命にはどんなファイルでも登録できますが、特にPDFファイルを効果的に処理できる機能を備えています。
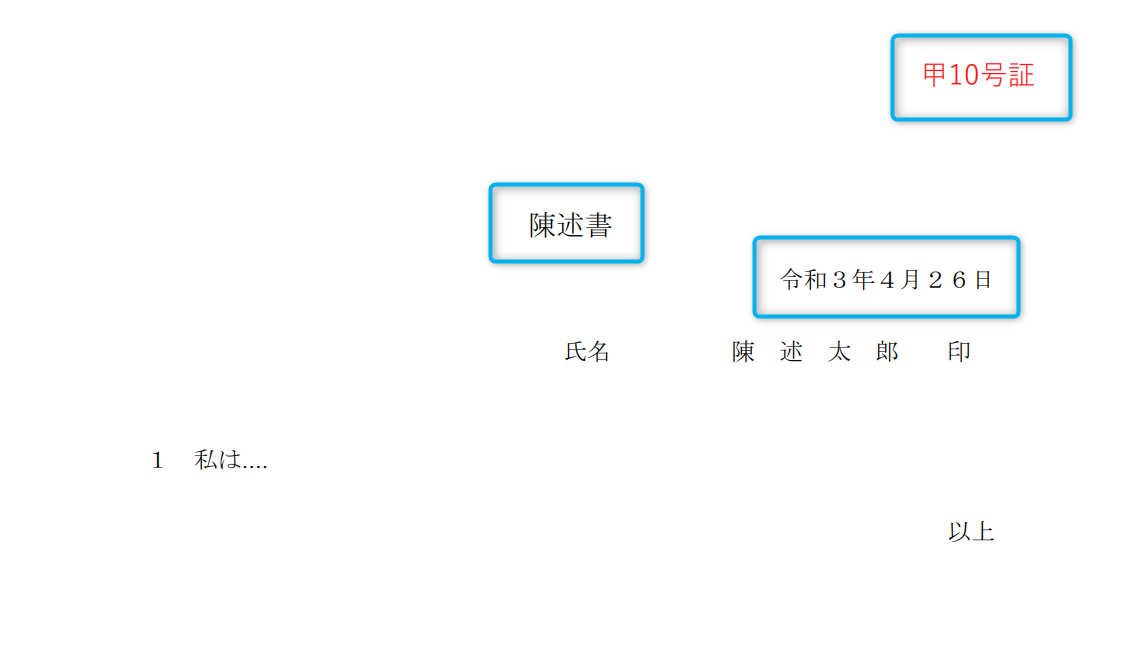
PDF化された文書の、タイトル・日付・証拠番号などの書誌情報を、画像解析により自動認識することができます。
解析機能は弁護革命サーバーと通信をおこなって実施します。
この記事ではPDFファイルのみについて説明します。
解析機能で何ができるか
「解析機能で何ができるか」の見出しへのリンクPDFファイルのタイトル・日付・証拠番号などの書誌情報を自動認識します。 また、全文テキストを認識できます。
PDFファイルにあらかじめOCRをかけることは必要ありません。
書誌情報の認識
「書誌情報の認識」の見出しへのリンク以下の情報を認識できます。
- タイトル
- 作成日
- 証拠番号
- 供述者(一部の書類に限る)
裁判所に提出されるような定型の書類では高い認識精度を発揮します。 全部事項証明書なども判別できます。
非定型な書類の認識率は落ちます。
全文テキストの認識
「全文テキストの認識」の見出しへのリンク画像状態のPDFファイルを解析して、全文テキストを認識します。 この全文テキストは、「テキスト検索」機能などで、串刺し検索できるようになります。
PDFファイルにも全文テキストは埋め込まれます。
高精度かつ高速である点も特長です。
通信環境などによりますが、トップスピードで毎秒10ページ程度処理できます。
解析できるファイル
「解析できるファイル」の見出しへのリンク画像解析の対象はPDFファイルです。 PNG, JPEG, TIFFなどの画像ファイルは対象外です。
ワード、エクセル、パワーポイント、テキストファイルに対しては、全文テキストをファイルからそのまま抽出して認識します。 もちろんテキスト検索機能で検索できます。
保護されたPDFは解析できないことがある
「保護されたPDFは解析できないことがある」の見出しへのリンクPDFファイルに編集不可のロックがかかっている場合などには、解析がおこなえない場合があります。 この場合は、次のように処理されます。
- PDFのファイル名を解釈して、ファイル登録が実施される
- 登録されたPDFは正常に閲覧できる
- 解析機能は発動しない
- 全文テキストデータは抽出できない
- PDFファイルのページ数表示が0となる
オプション
「オプション」の見出しへのリンク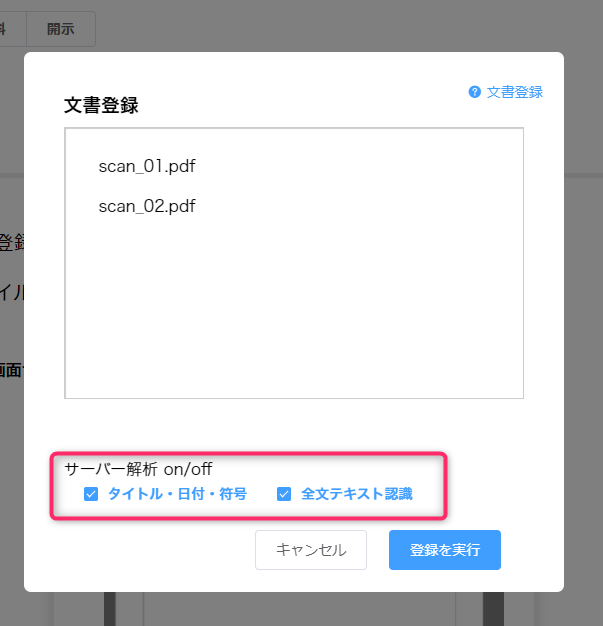
サーバー解析 on/offという箇所に、2つのオプションがあります。
☑️ タイトル・日付・符号
「☑️ タイトル・日付・符号」の見出しへのリンクONの場合
このオプションをオンにすると、タイトル、作成日、証拠番号、供述者(刑事事件の供述調書に限る)の解析をおこないます。サーバーとの通信がおこなわれます。
OFFの場合
このオプションをオフにした場合には、ファイル名を解釈して、タイトル、作成日、証拠番号、供述者の情報を取り出します。
☑️ 全文テキスト認識
「☑️ 全文テキスト認識」の見出しへのリンクこのオプションをオンにすると、サーバー通信をおこなって全文テキストを解析します。 このオプションをオフにした場合には、サーバーとの通信をおこないません。既にテキスト認識済みの場合には、そのテキストを抽出します。
☑️ 組み合わせ
「☑️ 組み合わせ」の見出しへのリンク一方をオン、一方をオフにすることもできます。 たとえば「ファイル名を既に正確に付けているが、OCRはできていない」という場合は、「タイトル・日付・符号」はオフ、「全文テキスト認識」はオン、が有効です。
ルール「証拠番号だけは常にファイル名優先」
「ルール「証拠番号だけは常にファイル名優先」」の見出しへのリンクファイル名に証拠番号だけ書き込むというケースは多いのではないでしょうか。
甲1.pdf
甲2.pdf
甲3の1.pdf
甲3の2.pdf
甲4.pdf
甲5.pdf
このようなイメージです。せっかく記入した証拠番号を無視してしまうのはもったいないです。
弁護革命は、解析機能をオンにした場合でも、ファイル名に書かれた証拠番号は温存します。 上記の例だと以下のように処理されます。
- タイトル、作成日は、解析機能で自動認識
- 証拠番号は、ファイル名をそのまま採用
セキュリティ
「セキュリティ」の見出しへのリンク弁護革命サーバーは案件のデータを一切預かりませんが、解析機能を利用した場合も同様です。
解析機能を利用する瞬間だけデータが送信されますが、処理が終わると直ちにデータが削除されます。
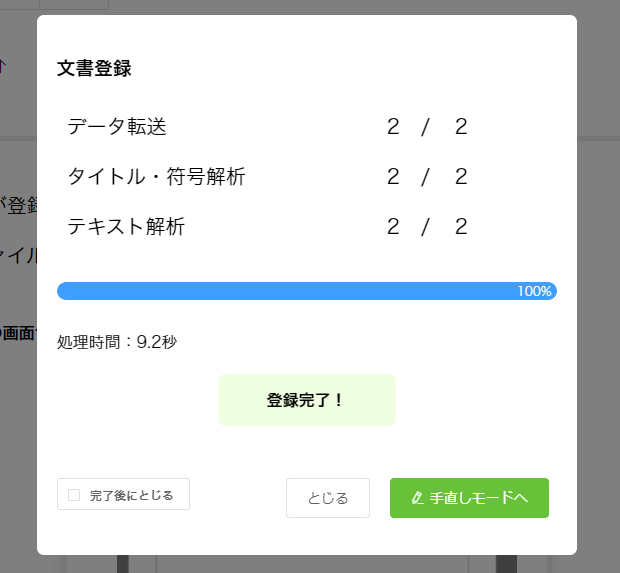
下記の「登録完了!」表示が出たときには、既に弁護革命サーバーにデータは残っていません。